PDF 파일을 한꺼번에 처리하다가 몇 개만 결과가 텅 비어 나올 때, 어떤 파일이 스캔본인지 미리 골라내고 따로 처리하는 방법입니다.
서류 PDF 여러 개에서 내용을 뽑아 정리하려고 파이썬으로 한꺼번에 돌렸는데, 대부분은 잘 뽑히고 몇 개만 빈 결과가 나왔습니다. 오류도 없고 파일도 정상적으로 열렸습니다.
열어보면 화면에는 글자가 멀쩡히 보입니다. 그런데 마우스로 글자를 드래그해 보면 선택이 안 되고 페이지 전체가 한 덩어리로 잡힙니다. 종이 서류를 스캐너로 찍어서 만든 PDF, 즉 글자가 아니라 사진이 들어 있는 파일이었습니다.
- PDF 에는 글자가 들어 있는 파일과 글자 사진이 들어 있는 파일이 섞여 있다
- 스캔본은 텍스트를 뽑아도 오류 없이 빈 값이 나온다
- 페이지마다 글자 수와 이미지 면적을 보면 스캔본을 기계적으로 가려낼 수 있다
- 골라낸 스캔본은 이미지로 렌더링해서 읽거나 OCR 로 넘긴다
1. 빈 결과가 나오는 이유
PDF 는 겉으로는 똑같아 보여도 속은 두 종류입니다. 워드나 한글에서 PDF 로 저장한 파일은 글자 정보가 그대로 들어 있어서 텍스트를 뽑을 수 있습니다.
반면 스캐너나 휴대폰 카메라로 찍어 만든 PDF 는 페이지마다 사진 한 장이 붙어 있는 구조입니다. 사람 눈에는 글자로 보여도 파일 안에는 글자가 없으니, 텍스트 추출을 하면 에러 없이 빈 문자열이 돌아옵니다.
이게 까다로운 이유는 실패처럼 보이지 않는다는 점입니다. 여러 파일을 한꺼번에 처리하면 빈 결과가 섞여 있어도 눈치채기 어렵고, 나중에 "이 서류 내용이 왜 없지?" 하고 나서야 알게 됩니다.
2. 스캔본 판별 기준: 글자 수와 이미지 면적
그래서 본격적으로 처리하기 전에 파일마다 종류부터 판별했습니다. 기준은 페이지 단위로 두 가지를 봅니다.
- 페이지에서 뽑히는 글자 수가 거의 없는가
- 페이지 면적의 절반 이상을 이미지 한두 장이 덮고 있는가
둘 다 해당하면 그 페이지는 스캔 페이지로 봅니다. 글자 수만 보면 원래 글자가 적은 표지나 빈 페이지까지 스캔본으로 잘못 잡히니, 이미지 면적을 같이 보는 게 중요합니다.
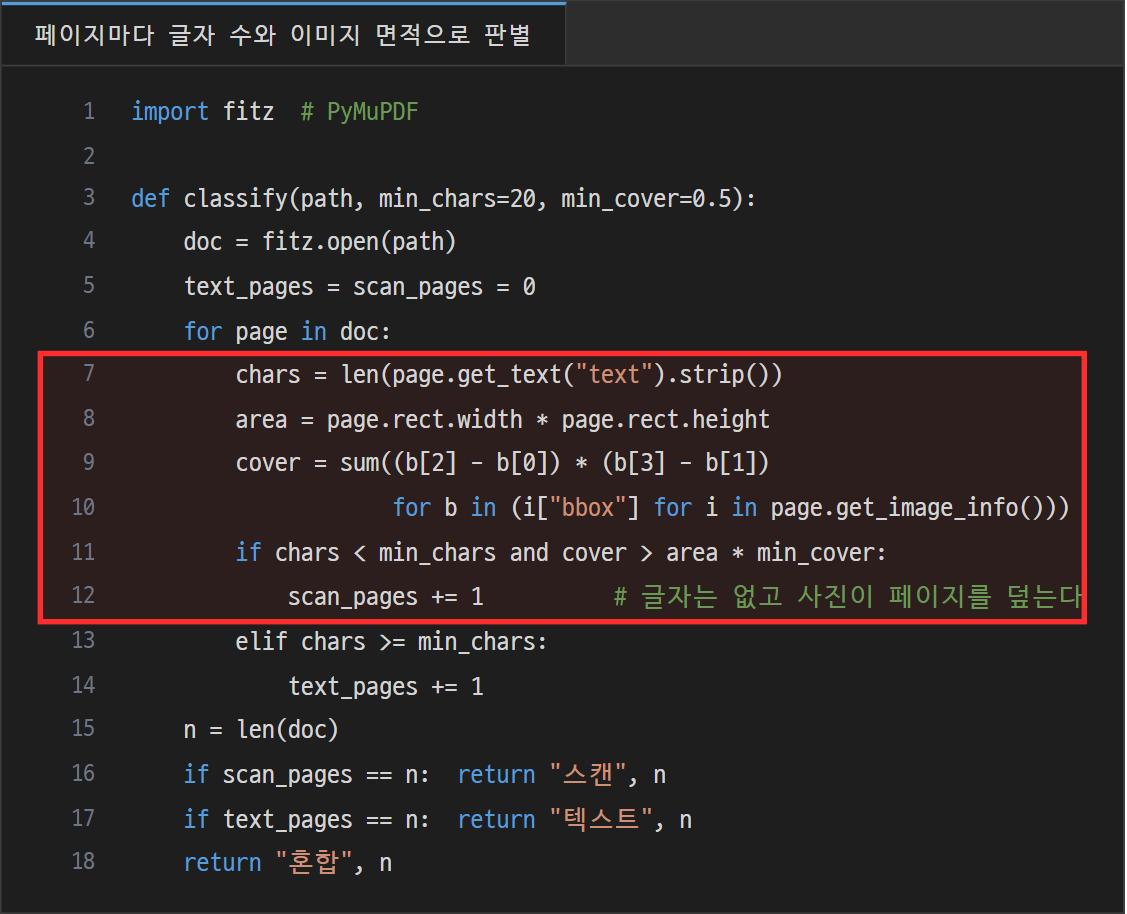
PyMuPDF 는 설치 한 번으로 텍스트 추출과 이미지 정보를 둘 다 볼 수 있어서 이런 판별에 편합니다. 기준값인 글자 20자와 면적 50% 는 제 문서 기준으로 잡은 값이라, 다루는 서류에 맞게 조정하면 됩니다.
3. 여러 파일을 한 번에 분류하기
판별 함수를 폴더 전체에 돌리면 파일마다 텍스트형, 스캔형, 혼합형으로 나뉩니다. 혼합형은 본문은 글자인데 중간에 화면 캡처를 페이지째 붙인 설계서처럼, 한 파일 안에 두 종류가 섞인 것입니다.
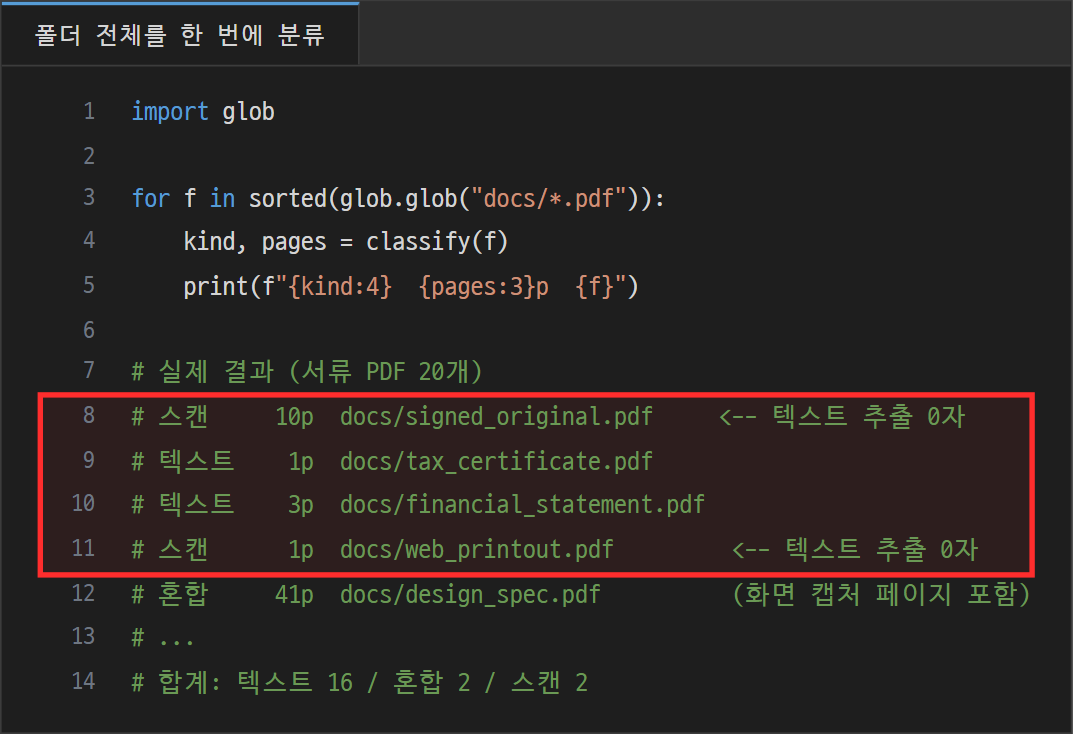
실제로 서류 PDF 20개가 든 폴더를 돌려 보니 텍스트형 16개, 혼합형 2개, 스캔형 2개로 나뉘었습니다. 스캔형 두 개는 도장 찍힌 원본을 스캔한 서류와 웹 화면을 이미지로 출력해 저장한 증명서였고, 텍스트를 뽑았을 때 빈 결과가 나온 파일도 정확히 이 두 개였습니다.
4. 골라낸 스캔본은 따로 처리한다
스캔본으로 분류된 파일은 텍스트 추출 대신 다른 길로 보냅니다.
- 몇 장 안 되면 페이지를 이미지로 렌더링해서 직접 읽는다
- 양이 많으면 OCR(이미지에서 글자를 인식하는 도구)로 넘긴다
- 혼합형은 스캔 페이지만 골라서 같은 처리를 한다
페이지를 이미지로 뽑는 것도 PyMuPDF 로 바로 됩니다. 해상도를 조금 높여 뽑아야 작은 글씨가 뭉개지지 않습니다.
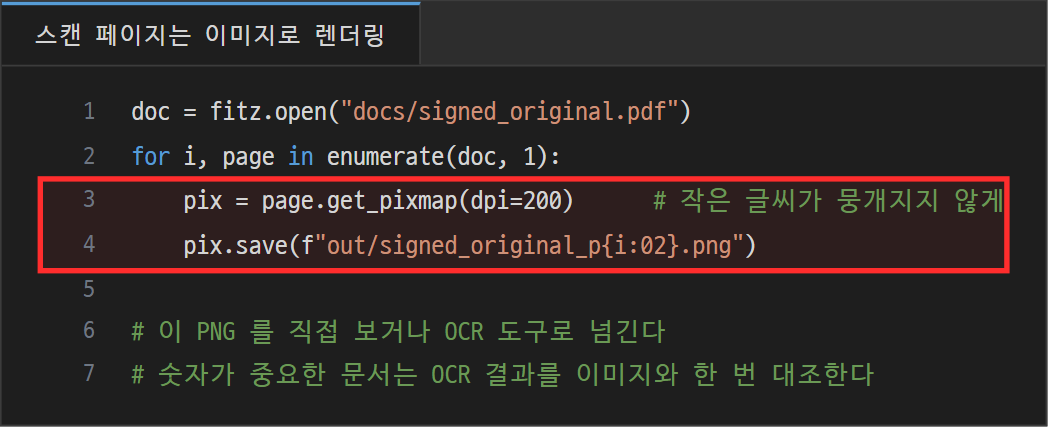
OCR 을 쓸 때는 한국어 인식 데이터를 따로 설치해야 하는 경우가 많고, 도장이나 표 테두리가 겹친 부분은 인식이 틀리기 쉽습니다. 계약서나 증명서처럼 숫자 하나가 중요한 문서라면 OCR 결과를 그대로 믿지 말고 렌더링한 이미지와 한 번 대조하는 편이 안전합니다.
5. 정리
PDF 처리에서 빈 결과가 나오면 코드를 의심하기 전에 그 파일에 글자가 들어 있기는 한지부터 보는 게 빠릅니다.
- PDF 는 글자형과 스캔형이 겉보기로는 구분되지 않는다
- 스캔본은 텍스트 추출이 에러 없이 빈 값을 준다
- 글자 수 + 이미지 면적으로 페이지마다 판별한다
- 폴더 전체를 돌려 텍스트형, 스캔형, 혼합형으로 먼저 나눈다
- 스캔본은 렌더링하거나 OCR 로 따로 처리하고, 중요한 숫자는 이미지와 대조한다
처리 순서를 "추출하고 나서 비었는지 본다"가 아니라 "판별하고 나서 추출한다"로 바꾸면, 빈 결과가 조용히 섞여 들어가는 일을 처음부터 막을 수 있습니다.
여기까지 PDF 중 스캔본을 골라내는 방법에 대해서 작성해봤습니다. 여기까지 읽어주셔서 감사합니다!
'일상' 카테고리의 다른 글
| 1원만 넘어도 혜택이 통째로 사라지는 세법 기준선 (금융소득 2,000만원과 월세 세액공제 총급여 8,000만원) (0) | 2026.09.25 |
|---|---|
| 상용 DB 라이선스가 컨테이너에서 "Corrupted license string"으로 거부될 때 (Altibase 버전과 하드웨어 바인딩) (0) | 2026.09.25 |
| 레거시 서비스를 모노레포로 묶을 때 분류 기준 (API와 배치를 가르는 법) (0) | 2026.09.25 |
| 같은 소스를 두 서비스로 배포할 때 태그 붙이는 법 (서비스별 접두어 태그) (0) | 2026.09.25 |
| 오래 쓴 젠킨스 잡 목록 정리하기 (이름 규칙과 안 쓰는 잡 격리) (0) | 2026.09.25 |


