파일에 한글이 멀쩡히 보이는데 그 단어로 grep을 하면 아무것도 안 잡힐 때, 원인을 확인하고 해결하는 방법입니다.
1. 문제: 눈에 보이는 한글이 grep에 안 잡힌다
오래된 시스템이나 구형 사이트에서 받은 HTML 파일을 열었더니 한글이 멀쩡히 보였습니다. 그런데 그 안의 한글 단어로 grep을 걸면 결과가 0건이었습니다. 영문이나 숫자로 검색하면 잘 잡히는데, 딱 한글만 안 잡혔습니다. 파일이 깨진 것도 아니고 화면엔 분명히 보이는데 검색만 안 되는 상황이었습니다.
- 파일을 열면 한글이 정상적으로 보임
- 그 한글로 grep 하면 결과 0건
- 영문·숫자로 grep 하면 정상적으로 잡힘
2. 원인: 파일이 UTF-8이 아니라 EUC-KR
grep은 글자가 아니라 "바이트"를 비교합니다. 검색어로 넣은 한글을 현재 환경의 기본 인코딩(보통 UTF-8)으로 바이트로 바꾼 뒤, 그 바이트 배열이 파일 안에 있는지 찾습니다. 그런데 파일이 EUC-KR(또는 CP949)로 저장돼 있으면, 같은 한글이라도 파일에 담긴 바이트가 완전히 다릅니다.
예를 들어 "가"라는 글자는 UTF-8에서 3바이트(EA B0 80)인데 EUC-KR에서는 2바이트(B0 A1)입니다. grep은 UTF-8 3바이트를 찾는데 파일엔 EUC-KR 2바이트가 들어 있으니, 같은 글자여도 서로 만나지 못해 0건이 나옵니다. 반대로 영문·숫자는 어떤 인코딩이든 같은 ASCII 바이트라서 인코딩과 상관없이 잘 잡힙니다.
- grep은 글자가 아니라 바이트를 비교함
- 같은 한글도 UTF-8과 EUC-KR은 바이트 배열이 다름
- 그래서 UTF-8 검색어가 EUC-KR 파일에서 안 잡힘
- 영문·숫자(ASCII)는 인코딩 무관하게 같은 바이트 -> 잡힘
3. 먼저 파일 인코딩부터 확인하기
해결에 앞서 파일이 정말 EUC-KR인지 확인합니다. HTML이면 문서 상단의 charset 선언을 보면 되고, 확실치 않으면 파이썬으로 여러 인코딩을 시도해서 한글이 제대로 풀리는 것을 찾으면 됩니다.
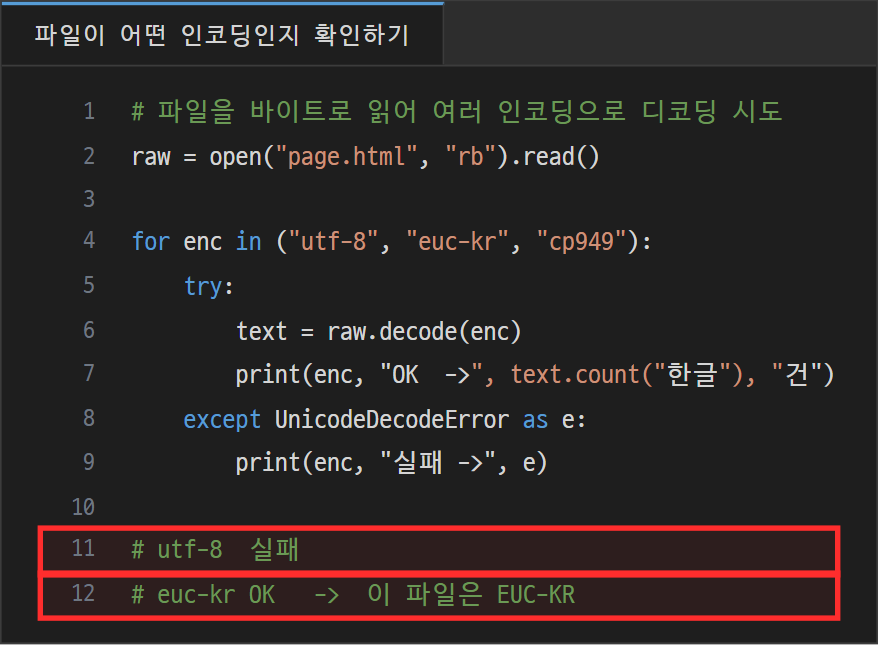
- HTML은 문서 상단 charset 선언 확인
- 애매하면 여러 인코딩으로 디코딩해보고 한글이 정상인 것 채택
- euc-kr로는 풀리고 utf-8로는 에러/깨짐이면 EUC-KR 확정
4. 해결 1: iconv로 변환해서 grep 하기
파일 몇 개를 빠르게 뒤질 때는 iconv로 EUC-KR을 UTF-8로 바꿔 파이프로 넘긴 뒤 grep 하면 됩니다. 파일 자체는 그대로 두고 검색만 UTF-8로 하는 방식입니다.

- iconv -f euc-kr -t utf-8 로 표준출력에 UTF-8로 흘려보냄
- 그 결과를 grep으로 받으면 한글이 잡힘
- 여러 파일이면 반복문으로 어느 파일에 있는지까지 출력
5. 해결 2: 파이썬으로 디코딩 후 처리하기
파일이 많거나 단순 검색을 넘어 표(테이블) 같은 구조에서 값을 뽑아야 하면 파이썬이 편합니다. 바이트로 읽어 euc-kr로 디코딩한 뒤 처리하면 됩니다. 이때 무심코 utf-8로 디코딩하면 에러가 나거나 글자가 깨지니, 인코딩을 명시하는 게 핵심입니다.

- open(f, "rb")로 바이트를 읽고 .decode("euc-kr")로 디코딩
- utf-8로 디코딩하면 에러나 깨짐 -> euc-kr/cp949 명시
- 디코딩 후엔 평소처럼 검색·정규식·테이블 파싱 가능
6. 정리
한글이 분명 보이는데 grep이 0건이면, 파일이 깨진 게 아니라 파일은 EUC-KR인데 grep은 UTF-8로 검색해서 바이트가 안 맞는 경우가 대부분입니다. 먼저 인코딩을 확인하고, 간단히는 iconv로 변환해 검색하고, 파일이 많거나 값을 뽑아야 하면 파이썬에서 euc-kr로 디코딩한 뒤 처리하면 깔끔하게 해결됩니다.
- 한글만 grep 0건 -> 파일이 EUC-KR인데 UTF-8로 검색한 것
- 인코딩 확인은 charset 선언이나 여러 인코딩 디코딩 시도로
- iconv 변환 검색, 또는 파이썬 decode("euc-kr")로 처리
함께 보면 좋은 글:
- 맥(MacOS) 자소 분리 처리 방법 (NFC/NFD 유니코드 정규화) - 한글이 자소로 풀릴 때, 같은 인코딩·유니코드 함정 편
- 윈도우 터미널 특수문자 겹침 (유니코드 모호폭) - 터미널의 폭 계산이 어긋나는 또 다른 함정
- 키로(Kiro) CLI 설정이 조용히 무시될 때 (예약된 built-in 에이전트 이름, 자동 승인이 매번 풀리는 이유) - 에러 없이 결과만 안 나오는 또 다른 함정
- 톰캣(Tomcat) allowLinking 취약점 조치하면서 기능은 살리기 (심볼릭 링크 대신 전용 Context 매핑) - 설정 한 줄이 기능을 떠받치고 있을 때
- 톰캣(Tomcat) 6에서 9로 올릴 때 만나는 함정 5가지 (기동 실패, 한글 전멸, 400 에러) - 컨테이너 기본 인코딩이 바뀌어 한글이 깨질 때
- PDF에서 텍스트를 뽑았는데 라벨만 나올 때 (폼 필드 레이어와 poppler 없이 이미지로 렌더링) - 파일은 멀쩡한데 값만 안 뽑히는 또 다른 함정
여기까지 한글이 보이는데 grep이 안 잡히는 문제(EUC-KR 인코딩 함정)에 대해서 작성해봤습니다. 여기까지 읽어주셔서 감사합니다!
'일상' 카테고리의 다른 글
| 톰캣(Tomcat) allowLinking 취약점 조치하면서 기능은 살리기 (심볼릭 링크 대신 전용 Context 매핑) (0) | 2026.07.29 |
|---|---|
| 키로(Kiro) CLI 설정이 조용히 무시될 때 (예약된 built-in 에이전트 이름, 자동 승인이 매번 풀리는 이유) (0) | 2026.07.29 |
| 웹 3티어에서 WAS 앞에 사설망 L4를 또 두는 이유 (공인 L4만으로 안 되나) (0) | 2026.07.17 |
| DB 카탈로그로 테이블 정의서 엑셀 수백 장 자동 생성하기 (템플릿 기반 Excel COM) (1) | 2026.07.17 |
| 사내 DRM 때문에 폐쇄망 PC에서 PPT를 직접 자동 생성하기 (PowerShell + Office COM) (0) | 2026.07.17 |


