PDF에서 값이 분명히 보이는데 추출하면 제목만 나올 때, 원인을 확인하고 해결하는 방법입니다.
1. 문제: 눈에는 보이는데 안 뽑힌다
계약서나 신청서 같은 PDF에서 텍스트를 뽑아 처리할 일이 있었습니다. 화면에는 항목 이름과 값이 나란히 보입니다. "성명: 홍길동", "금액: 1,200,000원" 이런 식으로요.
그런데 추출해 보면 "성명", "금액" 같은 라벨만 나오고 정작 값이 빠집니다. 홍길동도 1,200,000원도 없습니다. 파일이 깨진 것도 아니고 화면에는 멀쩡히 보이는데, 텍스트로만 뽑으면 반쪽이 사라집니다.
- 화면에는 라벨과 값이 다 보임
- 추출하면 라벨만 나오고 값이 없음
- 파일이 손상된 건 아님
2. 원인: 값이 다른 레이어에 있다
PDF는 한 장의 그림이 아니라 여러 층이 겹친 문서입니다. 그리고 양식 문서는 흔히 두 층으로 나뉩니다.
- 본문 텍스트 층 - "성명", "금액" 같은 고정된 라벨. 문서에 처음부터 박혀 있는 글자
- 폼 필드(form field) 층 - 나중에 채워 넣는 값. 입력칸에 얹히는 별도 객체
일반적인 텍스트 추출은 본문 텍스트 층만 읽습니다. 그래서 라벨은 나오고, 폼 필드에 들어간 값은 통째로 빠집니다. 화면에서는 둘이 겹쳐 보이니 한 덩어리 같지만, 데이터로는 완전히 다른 곳에 있는 겁니다.
관공서 증명서, 계약서, 신청서처럼 양식에 값을 채워 발급하는 문서에서 자주 일어납니다.
- 라벨 = 본문 텍스트 층 -> 추출됨
- 값 = 폼 필드 층 -> 일반 추출에서 누락
- 화면에선 겹쳐 보여도 데이터는 다른 층
3. 확인: 폼 필드를 직접 열어 본다
값이 폼 필드에 있는지부터 확인해야 합니다. 본문 텍스트가 아니라 필드 객체를 직접 조회하면, 거기 값이 들어 있는지 보입니다.
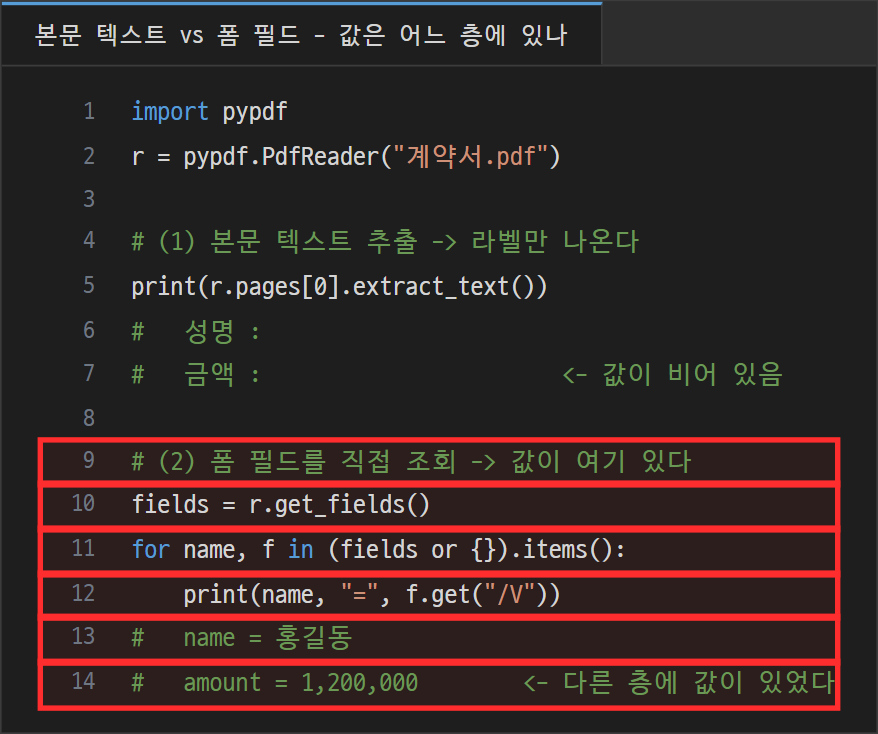
필드 목록에 값이 잡히면 원인이 확정됩니다. 이 경우 추출 대상을 본문에서 폼 필드로 바꾸면 값이 나옵니다.
4. 값이 아예 안 잡힐 때: 빈도로 찾는다
그런데 폼 필드로도 안 잡히는 경우가 있습니다. 값이 필드 객체가 아니라 이미지로 인쇄되듯 박혀 있거나, 좌표만 있는 텍스트 조각으로 흩어져 있을 때입니다. 이러면 어떤 방식으로도 "성명 옆의 값"을 구조적으로 못 집습니다.
이럴 때 쓴 방법은 빈도 분석입니다. 예를 들어 금액을 찾는다면, 문서 전체에서 숫자·쉼표로 이뤄진 조각을 다 모아 놓고 그중 가장 그럴듯한 것을 고릅니다. 구조로 못 찾으면 패턴으로 좁히는 겁니다.
- 폼 필드로도 안 잡히면 값이 이미지·좌표 조각일 수 있음
- 구조 추출을 포기하고 패턴(숫자·형식)으로 후보를 모음
- 후보 중 형식이 맞는 것을 고름
5. 눈으로 확인: poppler 없이 이미지로 렌더링
값을 뽑았으면 맞게 뽑혔는지 눈으로 확인해야 합니다. 그러려면 PDF를 이미지로 바꿔 봐야 하는데, 흔히 쓰는 도구는 poppler 같은 외부 프로그램 설치를 요구합니다. 폐쇄망이거나 설치 권한이 없으면 이게 막힙니다.
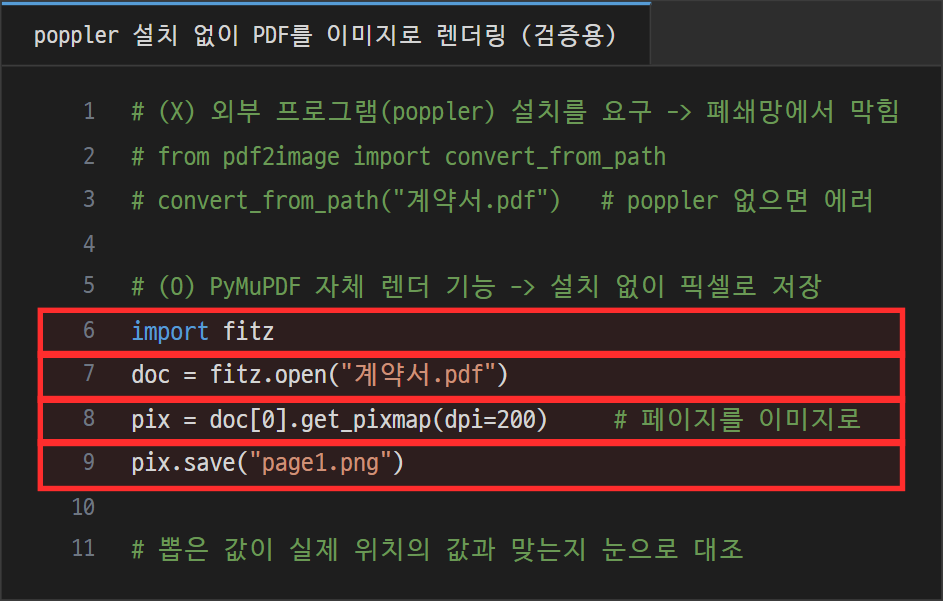
파이썬 PDF 라이브러리(PyMuPDF) 자체에 페이지를 픽셀로 렌더링하는 기능이 들어 있습니다. 외부 설치 없이 라이브러리 하나로 페이지를 이미지로 저장할 수 있어서, 뽑은 값이 실제 위치의 값과 맞는지 바로 대조할 수 있습니다.
- 검증하려면 PDF를 이미지로 봐야 함
- 외부 변환 도구는 설치가 필요해 폐쇄망에서 막힘
- PDF 라이브러리 자체 렌더 기능으로 설치 없이 해결
6. 정리
PDF에서 값이 안 뽑히면 파일을 의심하기 전에 "이 값이 어느 층에 있나" 부터 봐야 합니다. 라벨만 나온다는 건 대개 값이 폼 필드 같은 다른 층에 있다는 신호입니다.
그리고 뽑은 값은 반드시 눈으로 대조해야 합니다. 특히 빈도·패턴으로 찾은 값은 그럴듯한 오답일 수 있어서, 원본 이미지와 맞춰 보기 전엔 믿으면 안 됩니다.
- 값이 안 나오면 파일보다 "층"을 먼저 의심
- 라벨만 = 값이 폼 필드 등 다른 층에 있음
- 구조로 안 되면 패턴으로 후보를 좁힘
- 뽑은 값은 원본 이미지와 대조해 검증
- 이미지 변환은 외부 설치 없이 PDF 라이브러리 자체 기능으로
함께 보면 좋은 글:
- 한글이 분명 있는데 grep이 안 될 때 (EUC-KR과 UTF-8 인코딩 함정) - 파일은 멀쩡한데 안 읽히는 또 다른 함정 편
여기까지 PDF에서 라벨만 뽑히는 문제의 원인과 해결 방법에 대해서 작성해봤습니다. 여기까지 읽어주셔서 감사합니다!
'일상' 카테고리의 다른 글
| 백그라운드 작업이 "끝났다"는데 실제로는 안 끝났을 때 (프로세스 분리와 완료 판정) (0) | 2026.08.02 |
|---|---|
| 윈도우 Git Bash에서 python은 되는데 python3만 죽을 때 (WindowsApps 앱 실행 별칭) (0) | 2026.08.02 |
| 접근성 API가 안 통하는 윈도우 앱 자동화하기 (카카오톡 UI 자동화 함정 3가지) (0) | 2026.07.29 |
| 톰캣(Tomcat) 6에서 9로 올릴 때 만나는 함정 5가지 (기동 실패, 한글 전멸, 400 에러) (0) | 2026.07.29 |
| 톰캣(Tomcat) allowLinking 취약점 조치하면서 기능은 살리기 (심볼릭 링크 대신 전용 Context 매핑) (0) | 2026.07.29 |


