PDF에서 텍스트를 추출했는데, 화면에는 멀쩡히 보이는 단어가 정규식이나 문자열 검색으로는 잡히지 않는 경우가 있습니다. 특히 국내 관공서 서식이나 표가 많은 문서에서 자주 겪습니다. 왜 그런지, 어떻게 우회하는지 알아보는 글입니다.
1. 증상
추출한 텍스트를 출력해보면 내용은 다 있습니다. 그런데 그 안에서 특정 단어나 번호를 찾으면 결과가 비어 있습니다.
- 눈으로는 "신고내용"이 보이는데 "신고내용" in text 가 거짓
- 사업자번호 같은 숫자 형식을 찾는 정규식이 아무것도 못 잡음
- 표 안의 값을 라벨로 찾으려는데 라벨과 값이 붙지 않음
파일이 손상된 것도, 라이브러리가 잘못된 것도 아닙니다. 뽑히긴 뽑혔는데 모양이 다를 뿐입니다.
2. 원인 - PDF에는 "문장"이 없습니다
PDF는 워드 문서처럼 문장을 담고 있지 않습니다. 어떤 글자를 어느 좌표에 그릴지를 나열한 형식에 가깝습니다.
그래서 문서를 만든 프로그램이 글자 하나하나의 위치를 따로 지정해두면, 추출 도구는 그 사이를 공백이나 줄바꿈으로 채워서 내놓습니다. 자간을 벌려 놓은 제목, 칸에 맞춘 표, 세로로 쓴 항목명이 특히 그렇습니다.
실제로 어떤 서식을 추출해보니 이런 모양이었습니다.
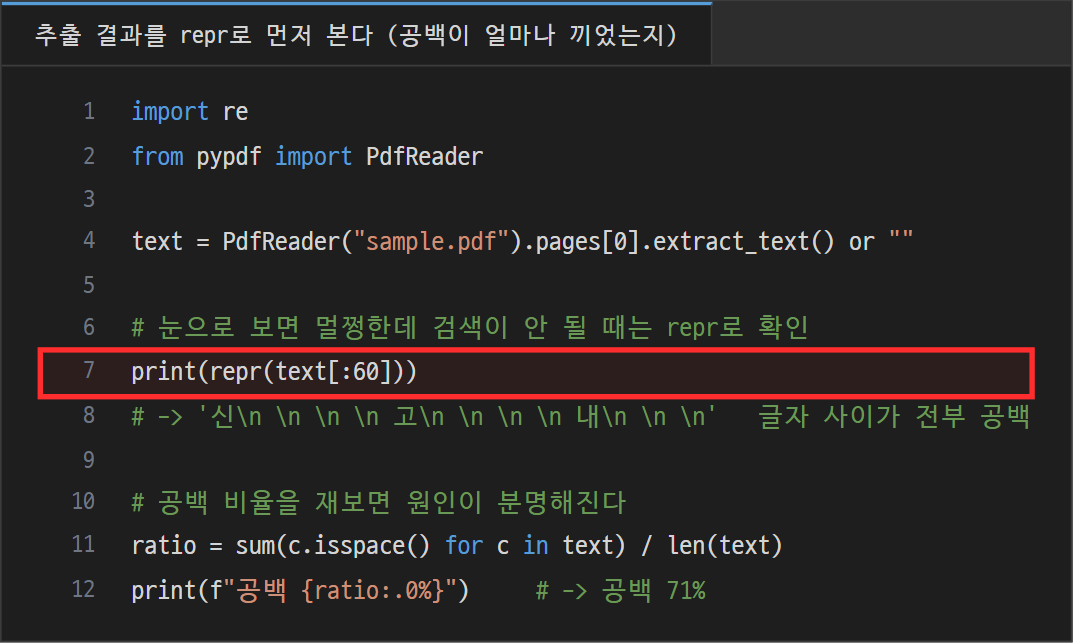
전체 문자의 71%가 공백이었고, 4,856자 중 실제 글자는 1,425자뿐이었습니다. "신고내용"이 신 다음에 줄바꿈과 공백이 열 개 넘게 끼고 고가 오는 식으로 뽑힌 것입니다. 이러니 검색이 될 리가 없습니다.
3. 해결 - 공백을 걷어낸 사본을 만든다
가장 간단하고 확실한 방법은 공백을 전부 지운 사본을 하나 만들어 거기서 찾는 것입니다.
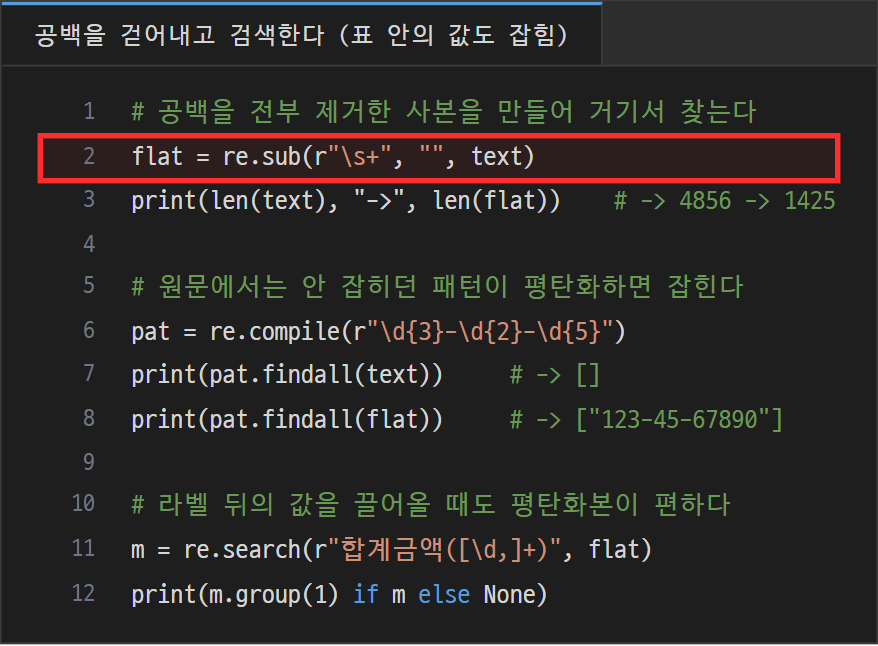
원문은 사람이 읽을 용도로 두고, 검색과 정규식은 평탄화한 사본에 겁니다. 표에서 "라벨 다음에 오는 값"을 끌어올 때도 이쪽이 훨씬 안정적입니다. 원문에서는 라벨과 값 사이에 무엇이 몇 개나 끼어 있을지 알 수 없기 때문입니다.
다만 주의할 점이 하나 있습니다. 띄어쓰기가 의미를 갖는 문장에는 쓰면 안 됩니다. 이 방법은 어디까지나 번호, 금액, 코드처럼 붙어 있어야 정상인 값을 뽑을 때 유효합니다.
4. 그래도 안 되면 텍스트를 포기합니다
평탄화로도 해결되지 않는 경우가 있습니다.
- 애초에 스캔한 이미지라 텍스트 레이어가 없는 문서
- 표의 행과 열이 뒤섞여 나와서 어느 값이 어느 항목인지 알 수 없는 경우
- 도면이나 화면 설계서처럼 배치 자체가 정보인 문서
이럴 때는 텍스트를 뽑으려 애쓰지 말고 페이지를 이미지로 렌더링하는 편이 빠릅니다.
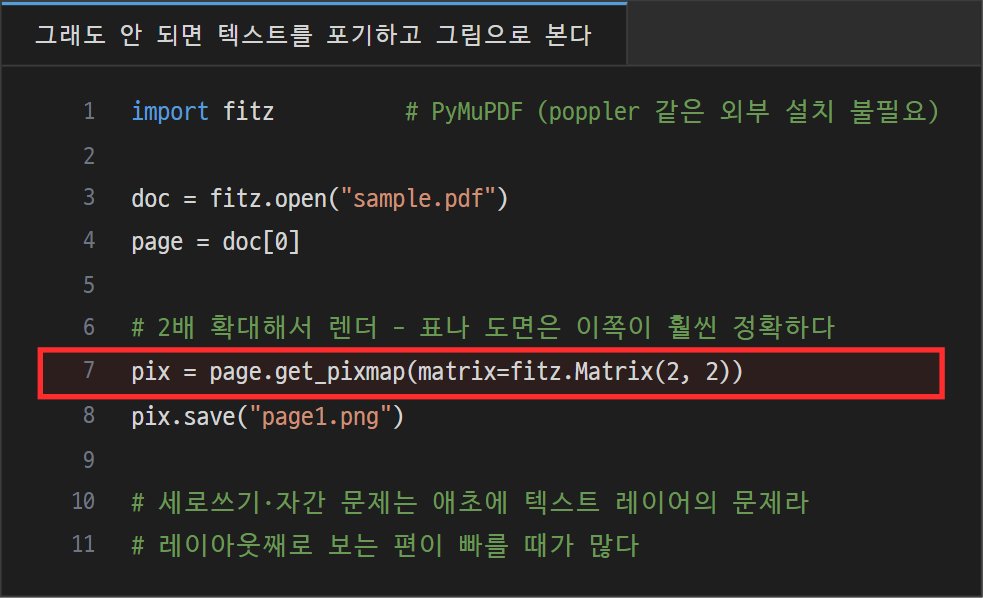
PyMuPDF를 쓰면 외부 프로그램 설치 없이 렌더링할 수 있습니다. 배율을 2배 정도 주면 표의 작은 글씨까지 알아볼 만하게 나옵니다.
5. 정리
한글 PDF에서 검색이 안 될 때 순서는 이렇습니다.
- 먼저 repr() 로 실제로 어떻게 뽑혔는지 확인
- 공백이 많으면 평탄화한 사본을 만들어 거기서 검색
- 그래도 안 되면 이미지로 렌더링해서 눈으로 확인
핵심은 PDF가 문장이 아니라 좌표에 찍힌 글자들의 모음이라는 점입니다. 추출 결과가 이상하면 파일을 의심하기 전에 먼저 원문을 그대로 출력해보면, 대부분 원인이 바로 보입니다.
여기까지 한글 PDF 텍스트 추출에서 공백과 세로쓰기 문제에 대해서 작성해봤습니다. 여기까지 읽어주셔서 감사합니다!
'일상' 카테고리의 다른 글
| 개인사업자와 법인, 무엇이 진짜 다를까 (시공 기사님들은 왜 법인을 안 낼까) (0) | 2026.08.15 |
|---|---|
| PDF를 AI로 읽을 때 한 가지 방법만 믿으면 안 되는 이유 (이미지 판독과 OCR 교차검증) (0) | 2026.08.15 |
| 피그마에서 PDF로 내보냈더니 한 장으로 나올 때 (프레임과 페이지의 관계) (0) | 2026.08.15 |
| 개인정보 유효기간제 폐지, 아직도 휴면계정 분리보관 하고 계신가요 (0) | 2026.08.15 |
| 2026년 개정 개인정보보호법, 9월 11일 시행 전에 볼 것 (대표자 책임과 과징금 10%) (0) | 2026.08.15 |


